Domain schnellverstellung.de kaufen?
Wir ziehen mit dem Projekt
schnellverstellung.de um.
Sind Sie am Kauf der Domain
schnellverstellung.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain schnellverstellung.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
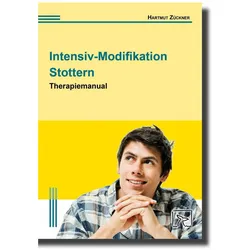
Intensiv-Modifikation Stottern, Fachbücher von Hartmut ZücknerDie Stottermodifikation (Nicht-Vermeide-Ansatz) ist ein Standardverfahren in der Behandlung stotternder Patienten. Das neue Gesamtwerk zur Intensiv-Modifikation Stottern für stotternde Jugendliche und Erwachsene fasst die bisherigen Teile zur Desensibilisierung und Modifikation zusammen und ergänzt diese um die Identifikations- und die Stabilisierungsphase. Das Therapiemanual gibt eine praktische und detaillierte Anleitung zur Durchführung der vier Therapiephasen. Übungshierarchien werden dargestellt und besonderes Augenmerk wird auf den Transfer in den Alltag gelegt. Ein Theorieteil liefert die rationale Grundlage dieses systematischen Konzepts. Zusammen mit den separat erhältlichen Patienteninformationen und Übungsaufgaben einschliesslich Übungs-CD liegt umfassendes Material zur Durchführung eines erprobten Therapieverfahrens vor, dessen Wirksamkeit in einer wissenschaftlichen Studie nachgewiesen wurde. Ein durchdachtes Gesamtwerk zur Stottermodifikation, das in keiner logopädischen Praxis fehlen darf.49,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
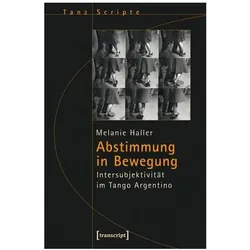
Abstimmung in Bewegung, Fachbücher von Melanie HallerAuf welche Weise können Abstimmungsprozesse im Tango erklärt werden? Anhand einer Mikroanalyse der Tanzpraktiken des Tango Argentino arbeitet Melanie Haller diese Prozesse heraus und setzt sie ins Verhältnis zu den Diskursen des Tango. Die transkulturelle Tanzkultur des Tango erweist sich dabei als eine Praktik von Intersubjektivierungsprozessen: Momente, in denen miteinander tanzende Subjekte Abstimmungen erreichen, die ihre eigene - als getrennt wahrgenommene - Subjektivität überschreiten und Intersubjektivierungen erlebbar machen.29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Intensiv-Modifikation Stottern, Fachbücher von Hartmut ZücknerDie Stottermodifikation (Nicht-Vermeide-Ansatz) ist ein Standardverfahren in der Behandlung stotternder Patienten. Das neue Gesamtwerk zur Intensiv-Modifikation Stottern für stotternde Jugendliche und Erwachsene fasst die bisherigen Teile zur Desensibilisierung und Modifikation zusammen und ergänzt diese um die Identifikations- und die Stabilisierungsphase. Das Therapiemanual gibt eine praktische und detaillierte Anleitung zur Durchführung der vier Therapiephasen. Übungshierarchien werden dargestellt und besonderes Augenmerk wird auf den Transfer in den Alltag gelegt. Ein Theorieteil liefert die rationale Grundlage dieses systematischen Konzepts. Zusammen mit den separat erhältlichen Patienteninformationen und Übungsaufgaben einschliesslich Übungs-CD liegt umfassendes Material zur Durchführung eines erprobten Therapieverfahrens vor, dessen Wirksamkeit in einer wissenschaftlichen Studie nachgewiesen wurde. Ein durchdachtes Gesamtwerk zur Stottermodifikation, das in keiner logopädischen Praxis fehlen darf.49,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
Ähnliche Suchbegriffe für Datenquellen
-
Abstimmung in Bewegung, Fachbücher von Melanie HallerAuf welche Weise können Abstimmungsprozesse im Tango erklärt werden? Anhand einer Mikroanalyse der Tanzpraktiken des Tango Argentino arbeitet Melanie Haller diese Prozesse heraus und setzt sie ins Verhältnis zu den Diskursen des Tango. Die transkulturelle Tanzkultur des Tango erweist sich dabei als eine Praktik von Intersubjektivierungsprozessen: Momente, in denen miteinander tanzende Subjekte Abstimmungen erreichen, die ihre eigene - als getrennt wahrgenommene - Subjektivität überschreiten und Intersubjektivierungen erlebbar machen.29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Heute Abstimmung!, Sachbücher von David Hesse, Philipp LoserDie Schweiz wird geformt von Wasser, Wetter, Stein und Volksabstimmungen. Seit der Gründung des modernen Bundesstaates 1848 haben die Stimmberechtigten mehr als 680-mal an der Urne Veränderungen der Nation beschlossen oder aufgehalten, mit einem Ja, einem Nein oder einem leeren Stimmzettel. Immer wieder haben Volksentscheide Weichen gestellt. Wir könnten heute in einer Schweiz ohne Armee leben, in einem EU-Staat, in einem Bund von nur 25 Kantonen, in einem Land ohne Frauenstimmrecht. Die Bevölkerung hat dafür gesorgt, dass es anders ist. Nach meist langen, gelegentlich erbitterten öffentlichen Debatten ist sie zur Abstimmung geschritten über die Gründung der SBB oder der AHV, über das Proporzwahlrecht ebenso wie über den Bau von Atomkraftwerken, ein neues Eherecht, eine vierte Landessprache oder den UNO-Beitritt. „Heute Abstimmung“ stellt dreissig Urnengänge vor, die bis heute nachwirken und das Land zu dem gemacht haben, das es heute ist. Und es ist das Porträt einer Nation aus Sicht der stimmberechtigten Bevölkerung.38,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.